学习之前,为什么一定要把扫描变换到模板?
统一模板便于建立体素对应关系,也方便把不同被试的数据组成批次。但配准与插值会改变原始几何表示,并增加预处理步骤。FlexiBrain 希望直接在原生空间学习:保留每次扫描的采集网格,不要求先把所有大脑非线性变换到同一个群体模板。
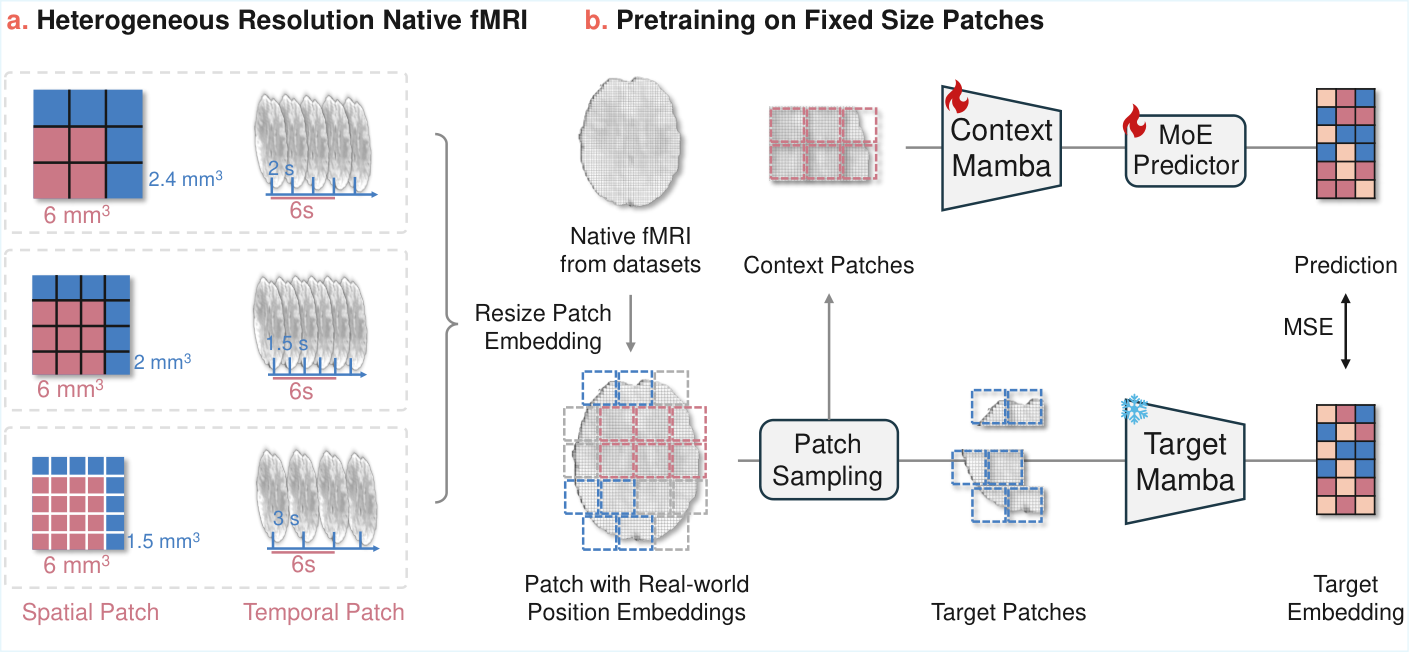
保留原始网格,又给模型带来新的问题:边长 4 个体素的 patch,在 3 mm 分辨率下覆盖 12 mm,在 2 mm 分辨率下却只覆盖 8 mm。重复时间(TR)变化时,相同帧数也对应不同的持续时间。因此,相同张量大小并不代表相同的物理范围。
共享物理感受野,而非固定的体素数量
FlexiBrain 读取体素间距和 TR,决定如何形成 token。上方原文方法图先将原生空间体积切成分辨率感知的 patch,再由上下文与目标分支学习共享潜在表征。最后通过轻量预测头,将特征适配到具体任务。
用毫米与秒定义 patch
Patch 的范围以物理单位指定。共享嵌入核根据需要覆盖的体素数和帧数调整尺寸,而不是为每一种分辨率重新学习 tokenizer;位置信息也使用物理坐标。模型因此能跨采集条件共享参数,无需先把所有输入重采样成同一网格。
用 Mamba-JEPA 预测缺失特征
上下文分支读取可见 patch,预测由滑动平均目标编码器提供的被掩蔽特征;Mamba 负责建模较长的体素 token 序列。预测潜在特征而非逐体素重建,也避免了不同分辨率带来不同大小的原始重建目标。
让上下文路径随 token 调整
Mixture-of-experts 模块在预测前变换上下文 token,为两条编码路径增加结构上的不对称,帮助避免不同输入都映射成相同特征的表征坍塌。最终得到的是感知扫描条件的统一编码器,而不是为每种协议训练不同模型。
分开检验:能处理不同分辨率,也能迁移数据集吗?
ABIDE、ADHD-200 和 ADNI 提供混合分辨率的预训练数据。评估包括 ASD、ADHD 分类,两项 ADNI 任务,以及 PPMI 三分类任务。PPMI 未参与预训练,因此对它进行下游适配,可以检验迁移到新数据集的能力。
异构输入下的外部预测
在 PPMI 上,FlexiBrain 的准确率为 74.31%,F1 为 70.54%。原文表 1 中,五项任务有四项获得最高平均准确率;ADNI 的 AD 分类则由 NeuroSTORM 取得更高结果。逐项呈现,更能说明表征在不同任务中的实际表现。
直接比较预处理方案
研究还分别用原生空间、T1w 对齐和模板空间输入,从头训练模型。图 3 中,原生空间方案获得最高准确率,该比较设置下的预处理时间由约 5 小时降至 3 分钟。这组实验单独检验输入流程,不与预训练后的迁移结果混为一谈。
| 任务 | FlexiBrain · ACC ↑ | 最高对比基线 · ACC ↑ |
|---|---|---|
| ADHD-200 | 69.76 ± 1.75% | SwiFT · 62.50 ± 1.50% |
| ABIDE · ASD | 65.45 ± 0.69% | BrainMass · 63.33 ± 1.18% |
| ADNI · MCI vs. CN | 79.16 ± 1.48% | NeuroSTORM · 66.67 ± 1.06% |
| ADNI · AD vs. CN | 82.34 ± 2.39% | NeuroSTORM · 84.26 ± 0.80% |
| PPMI · 外部数据集 | 74.31 ± 1.77% | NeuroSTORM · 68.25 ± 1.18% |
让原生空间成为可以共享建模的输入
FlexiBrain 用分辨率感知的 tokenization,兼顾个体几何与跨采集条件的参数共享。但分辨率和扫描中心的差异并未消失:受控降采样会降低表现,更严格的留出扫描中心测试仍有难度。使用模型时,正确的体素间距与 TR 是输入的一部分。
保留扫描本身的采集信息
按仓库流程准备原生空间 fMRI,并保留 tokenizer 所需的体素间距、TR 与物理坐标信息。原生空间建模不再要求非线性模板配准,但仍需要完成输入准备与质量控制。
Resolution-Agnostic Voxel-Level Encoding for Native fMRI
本文由 fMRI Atlas 根据上述原始研究整理。
本文更新:
原始概览
FlexiBrain learns voxel-level representations from native-space fMRI acquired at different spatial and temporal resolutions. It specifies patch sizes in physical units and resizes shared embedding kernels to match each scan, allowing one encoder to handle heterogeneous acquisitions without first warping every subject to a common template. A Mamba-JEPA backbone learns by predicting masked latent features rather than reconstructing the raw signal. A mixture-of-experts module in the context branch helps stabilize learning. The study evaluates five diagnostic tasks across ABIDE, ADHD-200, ADNI and PPMI, with PPMI used as an external dataset.
Summary of the original paper, submitted June 9, 2026.
BibTeX
@misc{wang2026flexibrain,
  title={FlexiBrain: Resolution-Agnostic Voxel-Level Encoding for Native fMRI},
  author={Wang, Mo and Ye, Wenhao and Xia, Junfeng and Xu, Minghao and Wen, Hongkai and Liu, Quanying},
  year={2026},
  eprint={2606.11500},
  archivePrefix={arXiv},
  primaryClass={eess.IV},
  doi={10.48550/arXiv.2606.11500},
  url={https://arxiv.org/abs/2606.11500}
}